Seu próximo cliente não vai digitar dez links azuis. Ele vai perguntar ao ChatGPT quem resolve o problema dele e vai confiar na resposta. Se a sua marca não está entre as fontes citadas, você não perdeu uma posição no ranking. Você ficou invisível para quem já estava pronto para comprar.
Este guia mostra os 6 passos para ser citado: entender por que o clique encolheu, como a IA escolhe fontes, como escrever para extração, qual base técnica entregar em Next.js, como liberar os crawlers e qual rotina mantém a citação. Com números de 2026 e código pronto para copiar. Para o panorama completo (preço, WhatsApp e velocidade), volte ao guia do site que vende todo dia.
Key Takeaways
- 68% das buscas terminam sem clique, e 83% quando há AI Overview; o clique no primeiro resultado cai de 15% para 8% (SparkToro e Pew Research, via Beancount.io, 2026).
- Cada resposta da IA dispara em média 2,3 buscas internas, e só 3,2% das fontes coincidem entre Google e ChatGPT; preço foi verificado na web em 100% dos casos (SEONextbr via Oxigenweb, 2026).
- 71% das páginas citadas pelo ChatGPT usam schema (Promptado, 2026); earned media responde por 84% das citações, Wikipedia é o domínio nº1 e 96% das respostas trazem cerca de 5 fontes (Muck Rack, mai/2026).
- Conteúdo atualizado é citado 4,3 vezes mais que conteúdo parado (Seer via Caramaschi).
Por que o clique orgânico encolheu em 2026?
Em 2026, 68% das buscas no Google terminam sem nenhum clique, e esse índice chega a 83% quando aparece um AI Overview no topo. Com o resumo da IA na tela, o clique no primeiro resultado orgânico cai de 15% para 8%. Os dados são do estudo de SparkToro e Pew Research compilado por Beancount.io em 2026.
Na prática, a impressão valiosa mudou de lugar. Antes, aparecer em primeiro garantia visita. Agora, a disputa acontece dentro da resposta gerada: ser citado ali equivale ao que a primeira posição era em 2020. Quem mede sucesso só por sessão orgânica vai ver o gráfico cair e concluir que o SEO morreu, quando na verdade o tráfego passou a nascer depois da citação.
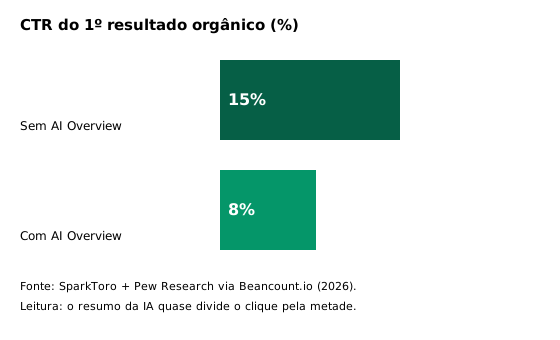
Clique no primeiro resultado com e sem AI Overview em 2026.
Como o ChatGPT e o AI Overview escolhem quem citar?
Um estudo brasileiro com 40 perguntas comparou Google e ChatGPT lado a lado e mediu o comportamento real da resposta gerada: cada resposta dispara em média 2,3 buscas internas, e apenas 3,2% das fontes se repetem entre os dois sistemas. Preço, buscado na web em 100% dos casos, foi o atributo mais verificado. A fonte é a SEONextbr, via Oxigenweb, 2026.
Duas conclusões saem daí. Primeira: otimizar só para o Google deixa o outro tabuleiro vazio, porque os dois sistemas bebem de fontes quase distintas. Segunda: dado comercial verificável (preço, prazo, incluso) é o que a IA mais confere, então esconder preço atrás de formulário é pedir para ficar de fora da resposta.
A camada de confiança decide o resto. Um levantamento brasileiro de 2026 encontrou schema em 71% das páginas citadas pelo ChatGPT (Promptado, 2026). E pesquisa da Muck Rack de maio de 2026 mostra que earned media (mídia conquistada, não o seu próprio site) responde por 84% das citações, com a Wikipedia como domínio nº1 e 96% das respostas trazendo cerca de 5 fontes. Tradução: a IA verifica você em terceiros antes de recomendar, então Reclame Aqui respondido, Google Business Profile consistente e cobertura em portais do setor pesam tanto quanto o seu conteúdo.
Como escrever conteúdo answer-first que a IA extrai?
Motores generativos extraem sentenças autocontidas, não dissertações. A regra prática é abrir cada seção com a resposta direta em 40 a 80 palavras e só depois aprofundar com tabela, lista ou exemplo. Quem enrola dez parágrafos antes do ponto raramente é citado, mesmo com o conteúdo correto.
Na execução, três hábitos resolvem a maior parte. Primeiro, H2 em forma de pergunta, igual à que o cliente faria ("quanto custa", "como funciona", "vale a pena"). Segundo, cada parágrafo de abertura precisa fazer sentido sozinho, porque é esse trecho que vira citação. Terceiro, tabelas e listas para dados comparáveis: preço, prazo, prós e contras, passos. A IA extrai estrutura com muito mais facilidade que prosa corrida.
O que não fazer: publicar texto gerado em massa sem revisão, criar FAQ genérica só para encher schema, esconder a resposta atrás de abas que o crawler não expande e trocar o preço real por "consulte-nos". Cada um desses hábitos apaga um sinal que a seção anterior provou ser decisivo. E exiba a data de atualização em cada página: frescor visível orienta o leitor e o modelo, como a rotina mensal detalha adiante.
Qual base técnica o Next.js precisa entregar?
A IA só cita o que ela consegue ler, e crawler de IA ignora JavaScript na maioria dos casos. No Next.js, isso significa renderizar o conteúdo crítico no servidor com SSR, exibir os dados no HTML visível e declarar a estrutura em JSON-LD válido. Um levantamento brasileiro de 2026 encontrou schema em 71% das páginas citadas pelo ChatGPT (Promptado, 2026).
O bloco abaixo é um @graph pronto com os cinco tipos que importam (Article, Person, Organization, FAQPage e BreadcrumbList). Troque os valores pelos seus e valide no teste de resultados ricos do Google antes de publicar. Repare na regra de ouro: todo dado do schema precisa existir idêntico no texto visível, porque divergência entre markup e página queima confiança com o buscador.
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://seusite.com.br/#organizacao",
      "name": "Sua Empresa",
      "url": "https://seusite.com.br/",
      "logo": "https://seusite.com.br/logo.png",
      "sameAs": ["https://www.linkedin.com/company/sua-empresa"]
    },
    {
      "@type": "Person",
      "@id": "https://seusite.com.br/autor/#pessoa",
      "name": "Nome do Autor",
      "jobTitle": "Especialista em Desenvolvimento e Marketing Digital",
      "worksFor": { "@id": "https://seusite.com.br/#organizacao" }
    },
    {
      "@type": "Article",
      "headline": "Título do artigo",
      "author": { "@id": "https://seusite.com.br/autor/#pessoa" },
      "publisher": { "@id": "https://seusite.com.br/#organizacao" },
      "datePublished": "2026-09-16",
      "dateModified": "2026-09-16",
      "mainEntityOfPage": "https://seusite.com.br/blog/seu-artigo"
    },
    {
      "@type": "FAQPage",
      "mainEntity": [
        {
          "@type": "Question",
          "name": "Quanto custa?",
          "acceptedAnswer": { "@type": "Answer", "text": "Resposta direta de 40 a 80 palavras, igual ao texto visível." }
        }
      ]
    },
    {
      "@type": "BreadcrumbList",
      "itemListElement": [
        { "@type": "ListItem", "position": 1, "name": "Blog", "item": "https://seusite.com.br/blog" },
        { "@type": "ListItem", "position": 2, "name": "Seu artigo", "item": "https://seusite.com.br/blog/seu-artigo" }
      ]
    }
  ]
}
No Next.js, prefira generateMetadata para título e descrição, renderize o artigo no servidor (App Router com Server Components) e reserve o cliente só para interação. Conteúdo crítico que depende de clique para aparecer simplesmente não existe para o crawler.
Como liberar os crawlers de IA e publicar o llms.txt?
Bloquear os crawlers de IA no robots.txt é o jeito mais rápido de sumir das respostas. Para ser encontrado, libere GPTBot, ClaudeBot, PerplexityBot e Google-Extended, publique um llms.txt na raiz com o mapa do conteúdo e mantenha nome, endereço e telefone idênticos em site, Google Business Profile e redes.
O robots fica assim (adapte os caminhos privados à sua realidade):
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: *
Disallow: /admin/
Disallow: /api/
O llms.txt na raiz (https://seusite.com.br/llms.txt) pode funcionar como índice editorial opcional: título, resumo, links e contato. Ele não é requisito de indexação nem garantia de citação. O guia oficial do Google para recursos de IA informa que a Busca não usa esse arquivo e não exige marcação especial para seus recursos generativos. Exemplo mínimo:
# Sua Empresa
> O que você resolve, para quem, em uma frase.

## Serviços
- [Criação de sites que vendem](https://seusite.com.br/sites): faixa de preço e prazo.
- [Agente de IA no WhatsApp](https://seusite.com.br/agente-ia): custo por conversa e payback.

## Conteúdo
- [Guia completo 2026](https://seusite.com.br/blog/guia): preços, ROI e checklist.

## Contato
- WhatsApp: https://wa.me/5561995910060
Sobre privacidade, uma trava honesta: liberar crawler não significa expor dado de cliente. Conteúdo público vai para a IA, dado pessoal nunca entra em página indexável. Se o seu agente de IA lida com dados reais, as travas de lei e arquitetura estão no guia LGPD + PL 2338.
Qual rotina mantém a citação mês após mês?
Conteúdo atualizado é citado 4,3 vezes mais que conteúdo parado, segundo levantamento da Seer divulgado por Caramaschi. Citação não é conquista permanente, é assinatura que se renova: dado envelhece, concorrente publica melhor e o modelo recicla as fontes. A rotina abaixo mantém sua marca nas respostas mês após mês.
Uma vez por mês, revise as duas páginas que mais vendem: atualize preço, prazo e data de modificação (visível e no schema), reforce uma tabela e responda uma pergunta nova de cliente. Em paralelo, alimente a corroboração externa: responda avaliações, mantenha o NAP idêntico em todo lugar e busque uma menção em portal do setor por trimestre. E meça como quem pilota produto: confira suas perguntas-chave no ChatGPT, no Perplexity e no AI Overview, anote quem foi citado e ajuste. Sem métrica, como mostra o guia dos pilotos que morrem, esforço vira teatro.
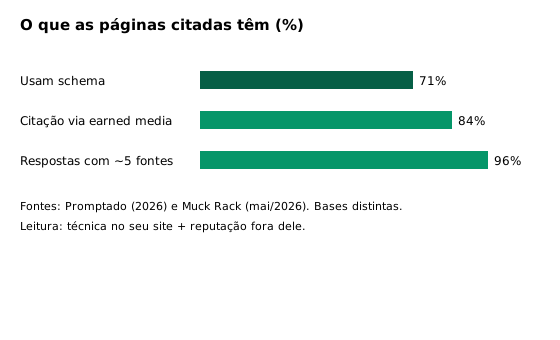
Sinais mais comuns nas citações de IA em 2026.
Perguntas frequentes
Em quanto tempo meu site aparece nas respostas da IA?
Modelos com busca em tempo real (Perplexity, ChatGPT com navegação) podem citar em poucas semanas com a base pronta. Entrar no conhecimento interno dos modelos leva meses, pelos ciclos de treinamento. Para sites com autoridade, o intervalo típico observado é de 60 a 120 dias após implementar AEO e GEO (CiaWebsites, 2026).
GEO substitui o SEO tradicional?
Não, GEO complementa. Velocidade, HTML legível, links internos e autoridade continuam valendo para o Google, e tudo isso também alimenta a IA. A diferença é a camada extra: resposta direta no topo, schema válido, crawlers liberados e corroboração externa. Quem faz GEO sem SEO constrói telhado sem parede.
Bloquear os crawlers de IA protege meus dados?
Bloquear tudo protege contra cópia, mas cobra o preço da invisibilidade: sem acesso, nenhuma citação. O equilíbrio correto é liberar o conteúdo público (que vende) e nunca expor dado pessoal em página indexável. Área logada, API e admin continuam bloqueados no robots, como no exemplo deste guia.
O llms.txt é obrigatório para ser citado?
Não é obrigatório, e nenhum estudo prova causalidade direta. Ele funciona como facilitador: um índice limpo do seu conteúdo que qualquer crawler entende sem adivinhar a navegação. Pense nele como a vitrine organizada da loja: ninguém é obrigado a entrar por ela, mas todo crawler agradece o caminho curto. Custa minutos para publicar e remove uma barreira de leitura, então entra no checklist pelo custo-benefício, não por promessa mágica.
Conclusão
- O clique encolheu (68% zero-click, 83% com AI Overview): a citação virou a nova primeira posição.
- A IA verifica em terceiros (84% earned media) e prefere dado estruturado (71% com schema).
- Base técnica: conteúdo acessível no HTML, rastreamento permitido e dados estruturados coerentes com a página.
llms.txté opcional; não garante presença nas respostas de IA. - Rotina mensal: atualizar páginas que vendem rende 4,3x mais citação.